Wie ist die Architektur
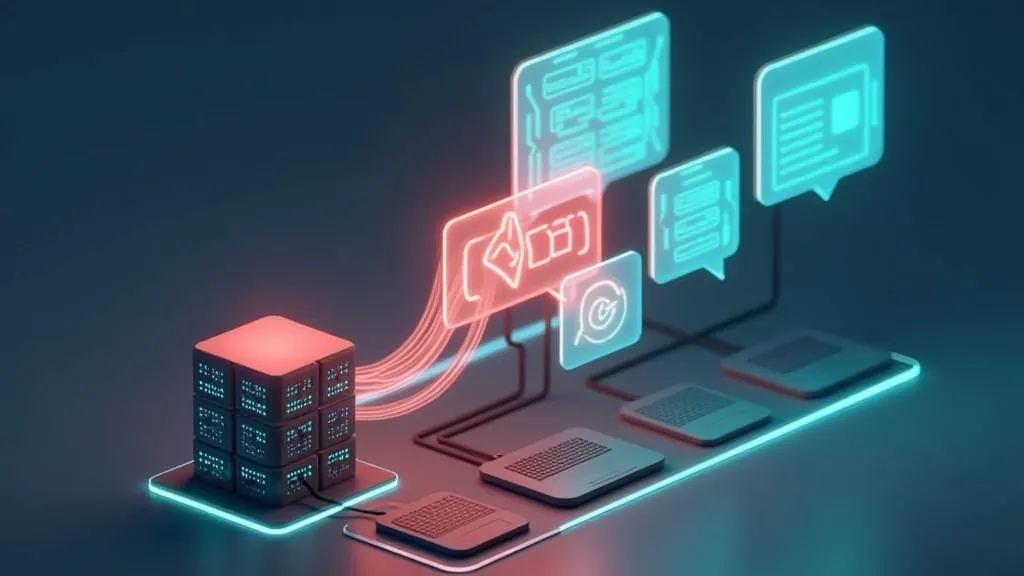
Ein eigener unzensierter Chatbot besteht aus drei Teilen: dem Benutzerinterface, deinem Server und der Sprach-API. Der Server ist das Zentrum. Er speichert den API-Schlüssel, verwaltet den Verlauf jedes Gesprächs und entscheidet, was an das Modell gesendet wird. Das Interface spricht nie direkt mit der API, da dies den Schlüssel preisgeben würde.
Diese API ist OpenAI-kompatibel: Das offizielle SDK funktioniert, indem du die Base URL auf https://api.llmsemcensura.com/v1 änderst und das Modell uncensored nutzt. Wenn du noch keinen Schlüssel hast, erstelle ihn hier; die Registrierung gewährt dir US$ 0,50 Testguthaben mit einem Klick.
Bevor du den Server aufbaust, validiere die Verbindung mit einem minimalen Test in Python, nur um sicherzustellen, dass Schlüssel und URL korrekt sind:
from openai import OpenAI
client = OpenAI(base_url="https://api.llmsemcensura.com/v1", api_key="SUA_CHAVE")
r = client.chat.completions.create(
model="uncensored",
messages=[{"role": "user", "content": "Olá, tudo bem?"}],
)
print(r.choices[0].message.content)Der Node-Server mit Streaming
Das Beispiel nutzt Express, um die Nachricht entgegenzunehmen und die Antwort über SSE (Server-Sent Events) zurückzugeben, sodass der Text schrittweise auf dem Bildschirm erscheint. Installiere die Abhängigkeiten mit npm install express openai und lege den Schlüssel in API_KEY.
import express from "express";
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://api.llmsemcensura.com/v1",
apiKey: process.env.API_KEY,
});
const SISTEMA =
"Você é a Lia, uma assistente de conversa direta e bem-humorada. " +
"Responda em português do Brasil. Os usuários são adultos.";
const sessoes = new Map(); // id da sessão -> histórico
const app = express();
app.use(express.json());
app.post("/chat", async (req, res) => {
const { id, mensagem } = req.body;
const historico = sessoes.get(id) ?? [];
historico.push({ role: "user", content: mensagem });
res.setHeader("Content-Type", "text/event-stream");
res.setHeader("Cache-Control", "no-cache");
try {
const stream = await client.chat.completions.create({
model: "uncensored",
messages: [{ role: "system", content: SISTEMA }, ...historico.slice(-12)],
stream: true,
max_tokens: 500,
});
let texto = "";
for await (const chunk of stream) {
const parte = chunk.choices[0]?.delta?.content ?? "";
if (parte) {
texto += parte;
res.write("data: " + JSON.stringify(parte) + "\n\n");
}
}
historico.push({ role: "assistant", content: texto });
sessoes.set(id, historico);
res.write("data: [FIM]\n\n");
} catch (e) {
res.write("data: " + JSON.stringify("erro: tente de novo em instantes") + "\n\n");
}
res.end();
});
app.listen(3000);Der Anfragekörper enthält eine id-Session-ID und die mensagem. Ein häufiger Fehler ist, den Header Content-Type: application/json bei der Anfrage zu vergessen, wodurch der Körper auf dem Server leer bleibt. Beim Testen im Browser oder über ein Anfrage-Tool siehst du, wie die Fragmente nacheinander eintreffen, und am Ende das Markierung [FIM].
Verlauf: Was speichern und senden
Die API hat kein Gesprächsgedächtnis. Jede Anfrage enthält die Nachrichten, die das Modell sehen muss. Im obigen Code bleibt der vollständige Verlauf im Map, und nur die letzten 12 Nachrichten werden an die API gesendet (historico.slice(-12)).
Warum beschneiden
Ohne Beschneidung wächst die Eingabe mit jeder Runde, und die Kosten steigen. Mit einem Kontextfenster von 100.000 Tokens würde ein sehr langes Gespräch zwar komplett passen, wäre aber teuer und langsam ohne proportionalen Gewinn.
Der System-Prompt
Er definiert, wer der Bot ist und wie er spricht. Kurze, spezifische Prompts funktionieren besser als lange Listen von Verboten und Anforderungen. Nenne die Sprache, den Ton, die durchschnittliche Antwortlänge und die Zielgruppe. Jeder Token des System-Prompts wird bei jeder Anfrage erneut gesendet, daher kosten 250 Tokens deutlich weniger als 2.000. Teste Änderungen einzeln und speichere die funktionierenden Versionen.
Langzeitgedächtnis
Wenn die Konversation sich alte Fakten merken soll, bitte das Modell, ab und zu eine kurze Zusammenfassung zu erstellen, und füge sie direkt nach dem System-Prompt ein. In der Produktion ersetze das Map durch eine Datenbank, da es beim Neustart des Servers zurückgesetzt wird und den Zustand nicht zwischen mehreren Instanzen teilt.
Kosten pro Nachricht
Der Preis beträgt 0,15 $ pro 1M Input-Token und 0,50 $ pro 1M Output-Token. Annahmen des Beispiels: System-Prompt mit 250 Token, Benutzer-Nachricht mit 80 Token, Antwort mit 300 Token und 12 Historien-Nachrichten (je 6 auf jeder Seite).
- Verlauf: 6 x 80 + 6 x 300 = 2.280 Token
- Input: 250 + 2.280 + 80 = 2.610 Token, oder US$ 0,0003915
- Output: 300 Token, oder US$ 0,00015
- Gesamt: US$ 0,0005415 pro Nachricht
Tausend Nachrichten kosten ca. US$ 0,54. Das Testguthaben von US$ 0,50 reicht für ca. 923 Nachrichten, und eine Aufladung von US$ 20 deckt ca. 36.900. Um die Aufladebänder und Boni zu sehen, öffne Preise. Fehlgeschlagene oder abgelehnte Anfragen werden nicht berechnet.
Ratenlimits, 429 und Warteschlangen
Der vollständige Schlüssel akzeptiert 8 parallele Anfragen und 300 pro Minute; der Test-Schlüssel 2 und 60. Wenn ein beliebter Chatbot diese Werte überschreitet, antwortet die API mit HTTP 429 und dem Code rate_limited oder concurrency. Bei temporärer Überlastung enthält 429 den Header Retry-After: 5. Denke daran, dass eine Streaming-Antwort den Platz bis zum Ende des Datenstroms belegt, daher halten lange Antworten die Parallelität länger auf.
Eine einfache Retry-Funktion respektiert dieses Intervall:
async function comRetry(fn, tentativas = 3) {
for (let i = 0; i < tentativas; i++) {
try {
return await fn();
} catch (e) {
if (e.status === 429 && i < tentativas - 1) {
await new Promise((r) => setTimeout(r, 5000)); // Retry-After: 5
continue;
}
throw e;
}
}
}Für viele gleichzeitige Benutzer platziere eine Warteschlange auf dem Server und begrenze, wie viele Gespräche parallel generiert werden.
Nutzungsregeln für Erwachsene
Das Modell ist offen, wird von einem unabhängigen Anbieter gehostet und antwortet ohne Inhaltsfilter für die legale Nutzung durch Erwachsene. Wer einen solchen Chatbot veröffentlicht, übernimmt die Verantwortung für die Nutzung. Einige grundlegende Praktiken:
- Altersüberprüfung. Fordere die Bestätigung, dass der Benutzer volljährig ist, bevor die erste Unterhaltung stattfindet, und nimm dies in die Nutzungsbedingungen deines Dienstes auf.
- Verbot von Minderjährigen. Sexuelle Inhalte, die Minderjährige einbeziehen, sind verboten, ohne Ausnahme. Blockiere in deiner Schicht jede Persona oder Anfrage in diese Richtung.
- Limit pro Benutzer. Lege ein tägliches Nachrichtenlimit fest, um Missbrauch und unerwartete Ausgaben zu vermeiden.
- Datenschutz. Speichere nur das Nötigste und teile mit, was gespeichert wird. In dieser API werden die Prompts nicht zum Training verwendet.
- Nur Text. Die API generiert keine Bilder, Audio oder Video.
Nächste Schritte
Mit der Basis sind die nützlichsten Verbesserungen: Chats in der Datenbank speichern, deinen Saldo über den Header X-Balance-USD anzeigen, tools nutzen, damit der Bot deine Daten abfragen kann, und den JSON-Modus für strukturierte Ausgaben. Die Dokumentation beschreibt jedes Feature. Um zu verstehen, was sich ändert, wenn man die Inhaltsfilter eines Modells entfernt, und wie das mit deinem Produkt zusammenhängt, lies KI ohne Filter.
Aufladungen reichen von 20 US$ bis 500 US$, in USDT im TRC20-Netzwerk oder USDC im Base-Netzwerk.
