Jak wygląda architektura
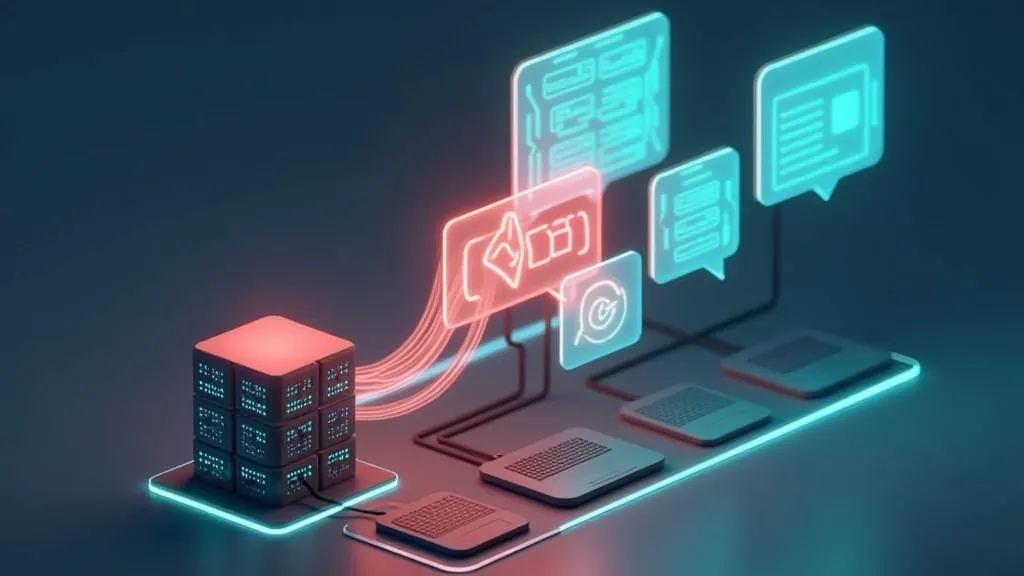
Własny chatbot bez cenzury ma trzy elementy: interfejs użytkownika, Twój serwer i API do modeli językowych. Serwer jest centrum. Przechowuje klucz API, utrzymuje historię każdej rozmowy i decyduje, co wysłać do modelu. Interfejs nigdy nie komunikuje się bezpośrednio z API, bo ujawniłoby to klucz.
To API jest kompatybilne z OpenAI: oficjalne SDK działa po zmianie Base URL na https://api.llmsemcensura.com/v1 i użyciu modelu uncensored. Jeśli nie masz jeszcze klucza, utwórz go tutaj; rejestracja daje prawo do US$ 0,50 przedpłaconego kredytu, jednym kliknięciem.
Przed skonfigurowaniem serwera zwaliduj połączenie minimalnym testem w Pythonie, tylko dla pewności, że klucz i URL są poprawne:
from openai import OpenAI
client = OpenAI(base_url="https://api.llmsemcensura.com/v1", api_key="SUA_CHAVE")
r = client.chat.completions.create(
model="uncensored",
messages=[{"role": "user", "content": "Olá, tudo bem?"}],
)
print(r.choices[0].message.content)Serwer w Node ze strumieniowaniem
Przykład używa Express do odbierania wiadomości i zwracania odpowiedzi przez SSE (server-sent events), dzięki czemu tekst pojawia się stopniowo na ekranie. Zainstaluj zależności przez npm install express openai i ustaw klucz w API_KEY.
import express from "express";
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://api.llmsemcensura.com/v1",
apiKey: process.env.API_KEY,
});
const SISTEMA =
"Você é a Lia, uma assistente de conversa direta e bem-humorada. " +
"Responda em português do Brasil. Os usuários são adultos.";
const sessoes = new Map(); // id da sessão -> histórico
const app = express();
app.use(express.json());
app.post("/chat", async (req, res) => {
const { id, mensagem } = req.body;
const historico = sessoes.get(id) ?? [];
historico.push({ role: "user", content: mensagem });
res.setHeader("Content-Type", "text/event-stream");
res.setHeader("Cache-Control", "no-cache");
try {
const stream = await client.chat.completions.create({
model: "uncensored",
messages: [{ role: "system", content: SISTEMA }, ...historico.slice(-12)],
stream: true,
max_tokens: 500,
});
let texto = "";
for await (const chunk of stream) {
const parte = chunk.choices[0]?.delta?.content ?? "";
if (parte) {
texto += parte;
res.write("data: " + JSON.stringify(parte) + "\n\n");
}
}
historico.push({ role: "assistant", content: texto });
sessoes.set(id, historico);
res.write("data: [FIM]\n\n");
} catch (e) {
res.write("data: " + JSON.stringify("erro: tente de novo em instantes") + "\n\n");
}
res.end();
});
app.listen(3000);Ciało żądania zawiera id sesji oraz mensagem. Częstym błędem jest pominięcie nagłówka Content-Type: application/json w wywołaniu, co powoduje puste ciało po stronie serwera. Testując przez przeglądarkę lub narzędzie do wysyłania żądań, powinieneś widzieć przychodzące fragmenty jeden po drugim, a na końcu znacznik [FIM].
Historia: co przechowywać i co wysyłać
API nie pamięta rozmowy. Każde wywołanie przekazuje wiadomości, które model musi zobaczyć. W powyższym kodzie pełna historia znajduje się w Map, a do API trafiają tylko ostatnie 12 wiadomości (historico.slice(-12)).
Dlaczego obcinać
Bez obcinania wejście rośnie z każdą rundą, a koszt rośnie wraz z nim. Przy oknie 100 000 tokenów nawet bardzo długa rozmowa zmieściłaby się cała, ale byłaby droga i wolna bez proporcjonalnej korzyści.
Prompt systemowy
Określa, kim jest bot i jak mówi. Krótkie, konkretne prompty działają lepiej niż długie listy zakazów i wymagań. Podaj język, ton, średnią długość odpowiedzi i grupę docelową. Każdy token promptu systemowego jest wysyłany w każdym zapytaniu, więc 250 tokenów kosztuje znacznie mniej niż 2000. Testuj zmiany po jednej i zapisuj działające wersje.
Pamięć długotrwała
Jeśli rozmowa musi pamiętać stare fakty, poproś model od czasu do czasu o krótkie streszczenie i umieść je zaraz po promptie systemowym. W produkcji zamień Map na bazę danych, bo jest resetowany przy restarcie serwera i nie dzieli stanu między wieloma instancjami.
Ile kosztuje każda wiadomość
Cena to US$ 0,15 za 1M tokenów wejściowych i US$ 0,50 za 1M wyjściowych. Założenia przykładu: prompt systemowy 250 tokenów, wiadomość użytkownika 80, odpowiedź 300 i 12 wiadomości historii (po 6 z każdej strony).
- Historia: 6 x 80 + 6 x 300 = 2 280 tokenów
- Wejście: 250 + 2 280 + 80 = 2 610 tokenów, czyli US$ 0,0003915
- Wyjście: 300 tokenów, czyli US$ 0,00015
- Razem: US$ 0,0005415 za wiadomość
Tysiąc wiadomości kosztuje około US$ 0,54. Darmowy kredyt próbny w wysokości US$ 0,50 starcza na około 923 wiadomości, a doładowanie za US$ 20 pokrywa około 36 900. Aby zobaczyć poziomy doładowania i bonusy, otwórz cennik. Nieudane lub odrzucone wywołania nie są rozliczane.
Limity, 429 i kolejki
Pełny klucz obsługuje 8 zapytań jednocześnie i 300 na minutę; próbny: 2 i 60. Gdy popularny chatbot przekroczy limit, API zwraca HTTP 429 z kodem rate_limited lub concurrency. Przy tymczasowym przeciążeniu 429 zawiera Retry-After: 5. Pamiętaj, że odpowiedź strumieniowa zajmuje miejsce do końca przepływu, więc długie odpowiedzi dłużej ograniczają równoległość.
Prosta funkcja ponawiania szanuje ten interwał:
async function comRetry(fn, tentativas = 3) {
for (let i = 0; i < tentativas; i++) {
try {
return await fn();
} catch (e) {
if (e.status === 429 && i < tentativas - 1) {
await new Promise((r) => setTimeout(r, 5000)); // Retry-After: 5
continue;
}
throw e;
}
}
}Dla wielu użytkowników jednocześnie dodaj kolejkę na serwerze i ogranicz liczbę równoległych rozmów.
Zasady użytkowania dla dorosłych
Model jest otwarty, hostowany przez niezależnego dostawcę i odpowiada bez odrzucania treści dla legalnego użytku przez osoby dorosłe. Twórca chatbota przejmuje odpowiedzialność za jego użycie. Oto kilka podstawowych praktyk:
- Weryfikacja wieku. Wymagaj potwierdzenia, że użytkownik jest pełnoletni przed rozpoczęciem pierwszej rozmowy i uwzględnij to w regulaminie swojej usługi.
- Zakaz udziału nieletnich. Treści seksualne z udziałem nieletnich są zabronione bez wyjątku. Zablokuj na swoim poziomie każdą osobę lub żądanie w tym zakresie.
- Limit na użytkownika. Ustal dzienny limit wiadomości, aby zapobiec nadużyciom i nieoczekiwanym wydatkom.
- Prywatność. Przechowuj jak najmniej i informuj, co jest zapisywane. W tym API prompty nie są używane do trenowania.
- Tylko tekst. API nie generuje obrazów, dźwięku ani wideo.
Kolejne kroki
Po przygotowaniu bazy najprzydatniejszymi ulepszeniami są: zapisywanie konwersacji w bazie danych, wyświetlanie Twojego salda za pomocą nagłówka X-Balance-USD, używanie tools do pobierania danych przez bota oraz tryb JSON, gdy potrzebujesz strukturyzowanego wyjścia. Dokumentacja opisuje każdą z tych funkcji. Aby zrozumieć, co się zmienia przy usunięciu filtrów z modelu i jak to się ma do Twojego produktu, przeczytaj AI bez filtrów.
Doładowania wynoszą od US$ 20 do US$ 500, wyłącznie w USDT w sieci TRC20 lub USDC w sieci Base.
