Architecture du système
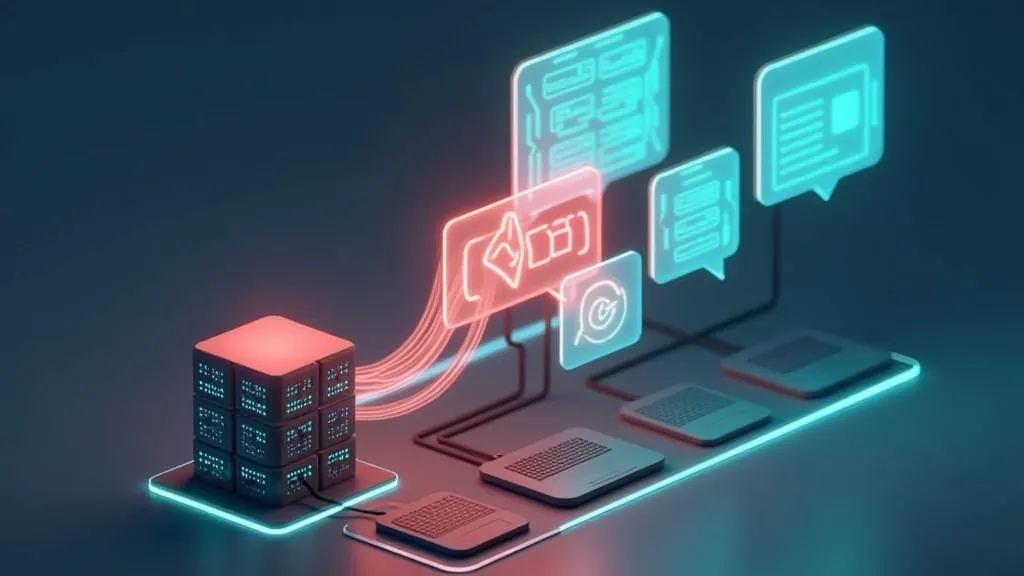
Un chatbot sans filtre propre comporte trois éléments : l'écran de l'utilisateur, votre serveur et l'API de langage. Le serveur est le centre. Il conserve la clé API, gère l'historique de chaque conversation et décide quoi envoyer au modèle. L'écran ne parle jamais directement à l'API, car cela exposerait la clé.
Cette API est compatible avec OpenAI : le SDK officiel fonctionne en modifiant l'URL de base vers https://api.llmsemcensura.com/v1 et en utilisant le modèle uncensored. Si vous n'avez pas encore de clé, créez-en une ici ; l'inscription offre un crédit d'essai de 0,50 US$ en un clic.
Avant de monter le serveur, validez la connexion avec un test minimal en Python, juste pour vous assurer que la clé et l'URL sont correctes :
from openai import OpenAI
client = OpenAI(base_url="https://api.llmsemcensura.com/v1", api_key="SUA_CHAVE")
r = client.chat.completions.create(
model="uncensored",
messages=[{"role": "user", "content": "Olá, tudo bem?"}],
)
print(r.choices[0].message.content)Le serveur Node avec streaming
L'exemple utilise Express pour recevoir le message et renvoyer la réponse via SSE (server-sent events), de sorte que le texte s'affiche progressivement à l'écran. Installez les dépendances avec npm install express openai et placez la clé dans API_KEY.
import express from "express";
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://api.llmsemcensura.com/v1",
apiKey: process.env.API_KEY,
});
const SISTEMA =
"Você é a Lia, uma assistente de conversa direta e bem-humorada. " +
"Responda em português do Brasil. Os usuários são adultos.";
const sessoes = new Map(); // id da sessão -> histórico
const app = express();
app.use(express.json());
app.post("/chat", async (req, res) => {
const { id, mensagem } = req.body;
const historico = sessoes.get(id) ?? [];
historico.push({ role: "user", content: mensagem });
res.setHeader("Content-Type", "text/event-stream");
res.setHeader("Cache-Control", "no-cache");
try {
const stream = await client.chat.completions.create({
model: "uncensored",
messages: [{ role: "system", content: SISTEMA }, ...historico.slice(-12)],
stream: true,
max_tokens: 500,
});
let texto = "";
for await (const chunk of stream) {
const parte = chunk.choices[0]?.delta?.content ?? "";
if (parte) {
texto += parte;
res.write("data: " + JSON.stringify(parte) + "\n\n");
}
}
historico.push({ role: "assistant", content: texto });
sessoes.set(id, historico);
res.write("data: [FIM]\n\n");
} catch (e) {
res.write("data: " + JSON.stringify("erro: tente de novo em instantes") + "\n\n");
}
res.end();
});
app.listen(3000);Le corps de la requête contient un id de session et la mensagem. Une erreur fréquente est d'oublier l'en-tête Content-Type: application/json lors de l'appel, ce qui laisse le corps vide sur le serveur. En testant via le navigateur ou un outil de requêtes, vous devez voir les morceaux arriver un par un et, à la fin, le marqueur [FIM].
Historique : que conserver et que transmettre
L'API n'a pas de mémoire de conversation. Chaque appel transmet les messages que le modèle doit voir. Dans le code ci-dessus, l'historique complet est stocké dans un Map et seuls les 12 derniers messages sont envoyés à l'API (historico.slice(-12)).
Pourquoi tronquer
Sans troncation, l'entrée augmente à chaque tour et le coût aussi. Avec une fenêtre de contexte de 100 000 tokens, une conversation très longue tiendrait même entièrement, mais serait coûteuse et lente sans gain proportionnel.
Le prompt système
Il définit l'identité du bot et sa façon de parler. Des prompts courts et spécifiques fonctionnent mieux que de longues listes d'interdictions et d'exigences. Indiquez la langue, le ton, la taille moyenne des réponses et le public. Chaque token du prompt système est renvoyé à chaque appel, donc 250 tokens coûtent bien moins cher que 2 000. Testez les modifications une par une et conservez les versions fonctionnelles.
Mémoire à long terme
Si la conversation doit se souvenir de faits anciens, demandez au modèle de temps en temps un résumé court et placez-le juste après le prompt système. En production, remplacez le Map par une base de données, car il se réinitialise au redémarrage du serveur et ne partage pas l'état entre plusieurs instances.
Coût de chaque message
Le prix est de 0,15 US$ par 1M de tokens d'entrée et de 0,50 US$ par 1M de sortie. Hypothèses de l'exemple : prompt système de 250 tokens, message utilisateur de 80, réponse de 300 et 12 messages d'historique (6 de chaque côté).
- Historique : 6 x 80 + 6 x 300 = 2 280 tokens
- Entrée : 250 + 2 280 + 80 = 2 610 tokens, soit 0,0003915 US$
- Sortie : 300 tokens, soit 0,00015 US$
- Total : US$ 0,0005415 par message
Mille messages coûtent environ US$ 0,54. Le crédit d'essai de US$ 0,50 couvre environ 923 messages, et une recharge de US$ 20 couvre environ 36 900. Pour voir les tranches de recharge et les bonus, ouvrez prix. Les appels échoués ou refusés ne sont pas facturés.
Limites, code 429 et files d'attente
La clé complète accepte 8 requêtes simultanées et 300 par minute ; la clé d'essai, 2 et 60. Lorsqu'un chat populaire dépasse ces limites, l'API répond HTTP 429 avec le code rate_limited ou concurrency. En cas de surcharge temporaire, le 429 inclut Retry-After: 5. Notez qu'une réponse en streaming occupe la place jusqu'à la fin du flux, donc les réponses longues maintiennent la concurrence plus longtemps.
Une fonction de retry simple respecte cet intervalle :
async function comRetry(fn, tentativas = 3) {
for (let i = 0; i < tentativas; i++) {
try {
return await fn();
} catch (e) {
if (e.status === 429 && i < tentativas - 1) {
await new Promise((r) => setTimeout(r, 5000)); // Retry-After: 5
continue;
}
throw e;
}
}
}Pour de nombreux utilisateurs simultanés, placez une file d'attente sur le serveur et limitez le nombre de conversations générées en même temps.
Règles d'utilisation pour adultes
Le modèle est ouvert, hébergé par un prestataire indépendant et répond sans refus de contenu pour un usage adulte légal. Qui publie un chatbot de ce type en assume la responsabilité. Voici quelques bonnes pratiques :
- Vérification de l'âge. Exigez la confirmation que l'utilisateur est majeur avant la première conversation et mentionnez-le dans les conditions de votre service.
- Interdiction aux mineurs. Le contenu sexuel impliquant des mineurs est interdit, sans exception. Bloquez à votre niveau toute personnalité ou demande dans ce sens.
- Limite par utilisateur. Définissez un plafond quotidien de messages pour éviter les abus et les dépenses inattendues.
- Confidentialité. Conservez le strict nécessaire et indiquez ce qui est stocké. Avec cette API, les prompts ne sont pas utilisés pour l'entraînement.
- Texte uniquement. L'API ne génère ni image, ni audio, ni vidéo.
Prochaines étapes
Une fois la base en place, les améliorations les plus utiles sont : sauvegarder les conversations dans une base de données, afficher votre solde via l'en-tête X-Balance-USD, utiliser tools pour permettre au bot d'interroger vos données, et le mode JSON lorsque vous avez besoin d'une sortie structurée. La documentation couvre chaque fonctionnalité. Pour comprendre ce qui change en retirant les filtres d'un modèle et comment cela s'articule avec votre produit, lisez IA sans filtre.
Les recharges vont de US$ 20 à US$ 500, en USDT sur le réseau TRC20 ou en USDC sur le réseau Base.
