Bagaimana arsitekturnya
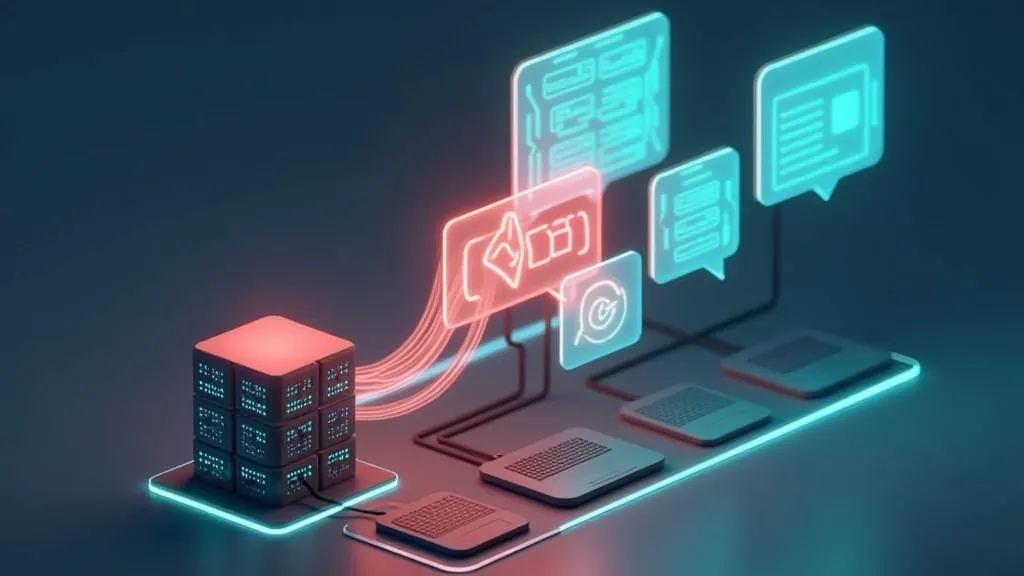
Sebuah chatbot tanpa filter memiliki tiga komponen: antarmuka pengguna, server Anda, dan API bahasa. Server adalah pusatnya. Server menyimpan kunci API, menjaga riwayat setiap percakapan, dan memutuskan apa yang dikirim ke model. Antarmuka tidak pernah berbicara langsung ke API karena hal itu akan mengekspos kunci.
API ini kompatibel dengan OpenAI: SDK resmi berfungsi dengan mengubah Base URL menjadi https://api.llmsemcensura.com/v1 dan menggunakan model uncensored. Jika Anda belum memiliki kunci, buatlah di sini; pendaftaran memberikan hak kredit uji coba senilai US$ 0,50, hanya dengan satu klik.
Sebelum menyiapkan server, verifikasi koneksi dengan tes minimal di Python, hanya untuk memastikan kunci dan URL benar:
from openai import OpenAI
client = OpenAI(base_url="https://api.llmsemcensura.com/v1", api_key="SUA_CHAVE")
r = client.chat.completions.create(
model="uncensored",
messages=[{"role": "user", "content": "Olá, tudo bem?"}],
)
print(r.choices[0].message.content)Server berbasis Node, dengan streaming
Contoh menggunakan Express untuk menerima pesan dan mengembalikan respons melalui SSE (server-sent events), sehingga teks muncul bertahap di layar. Instal dependensi dengan npm install express openai dan masukkan kunci di API_KEY.
import express from "express";
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://api.llmsemcensura.com/v1",
apiKey: process.env.API_KEY,
});
const SISTEMA =
"Você é a Lia, uma assistente de conversa direta e bem-humorada. " +
"Responda em português do Brasil. Os usuários são adultos.";
const sessoes = new Map(); // id da sessão -> histórico
const app = express();
app.use(express.json());
app.post("/chat", async (req, res) => {
const { id, mensagem } = req.body;
const historico = sessoes.get(id) ?? [];
historico.push({ role: "user", content: mensagem });
res.setHeader("Content-Type", "text/event-stream");
res.setHeader("Cache-Control", "no-cache");
try {
const stream = await client.chat.completions.create({
model: "uncensored",
messages: [{ role: "system", content: SISTEMA }, ...historico.slice(-12)],
stream: true,
max_tokens: 500,
});
let texto = "";
for await (const chunk of stream) {
const parte = chunk.choices[0]?.delta?.content ?? "";
if (parte) {
texto += parte;
res.write("data: " + JSON.stringify(parte) + "\n\n");
}
}
historico.push({ role: "assistant", content: texto });
sessoes.set(id, historico);
res.write("data: [FIM]\n\n");
} catch (e) {
res.write("data: " + JSON.stringify("erro: tente de novo em instantes") + "\n\n");
}
res.end();
});
app.listen(3000);Isi permintaan menyertakan id sesi dan mensagem. Kesalahan umum adalah lupa menyertakan header Content-Type: application/json saat memanggil, yang menyebabkan isi permintaan kosong di sisi server. Saat diuji melalui browser atau alat permintaan, Anda akan melihat potongan data muncul satu per satu, dan di akhir muncul penanda [FIM].
Riwayat: apa yang disimpan dan apa yang dikirim
API tidak memiliki memori percakapan. Setiap panggilan membawa pesan yang perlu dilihat model. Dalam kode di atas, riwayat lengkap ada di Map dan hanya 12 pesan terakhir yang dikirim ke API (historico.slice(-12)).
Mengapa memotong
Tanpa pemotongan, input tumbuh di setiap putaran dan biaya meningkat bersama. Dengan jendela konteks 100.000 token, percakapan yang sangat panjang bahkan akan muat sepenuhnya, tetapi akan mahal dan lambat tanpa peningkatan proporsional.
Prompt sistem
Ini menentukan siapa bot itu dan bagaimana cara bicaranya. Prompt pendek dan spesifik lebih baik daripada daftar panjang larangan dan persyaratan. Sebutkan bahasa, nada, ukuran rata-rata respons, dan audiens. Setiap token prompt sistem dikirim ulang di setiap panggilan, jadi 250 token jauh lebih murah daripada 2.000. Uji perubahan satu per satu dan simpan versi yang berhasil.
Memori jangka panjang
Jika percakapan perlu mengingat fakta lama, mintalah model untuk membuat ringkasan singkat secara berkala dan tempelkan segera setelah prompt sistem. Dalam produksi, ganti Map dengan basis data, karena ia direset saat server berjalan ulang dan tidak membagi status antar beberapa instans.
Berapa biaya setiap pesan
Harganya adalah US$ 0,15 per 1M token input dan US$ 0,50 per 1M output. Asumsi contoh: prompt sistem 250 token, pesan pengguna 80, respons 300, dan 12 pesan riwayat (6 di setiap sisi).
- Riwayat: 6 x 80 + 6 x 300 = 2.280 token
- Input: 250 + 2.280 + 80 = 2.610 token, atau US$ 0,0003915
- Output: 300 token, atau US$ 0,00015
- Total: US$ 0,0005415 per pesan
Seribu pesan berharga sekitar US$ 0,54. Kredit uji coba senilai US$ 0,50 cukup untuk sekitar 923 pesan, dan pengisian ulang senilai US$ 20 mencakup sekitar 36.900 pesan. Untuk melihat tier pengisian ulang dan bonus, buka harga. Panggilan yang gagal atau ditolak tidak dikenakan biaya.
Batas, 429, dan antrean
Kunci penuh menerima 8 permintaan secara bersamaan dan 300 per menit; kunci uji, 2 dan 60. Ketika chat populer melewati batas ini, API merespons HTTP 429 dengan kode rate_limited atau concurrency. Saat beban sementara, 429 datang dengan Retry-After: 5. Ingat bahwa respons streaming menempati slot hingga akhir aliran, jadi respons panjang menahan konkurensi lebih lama.
Fungsi retry sederhana menghormati interval ini:
async function comRetry(fn, tentativas = 3) {
for (let i = 0; i < tentativas; i++) {
try {
return await fn();
} catch (e) {
if (e.status === 429 && i < tentativas - 1) {
await new Promise((r) => setTimeout(r, 5000)); // Retry-After: 5
continue;
}
throw e;
}
}
}Untuk banyak pengguna secara bersamaan, letakkan antrean di server dan batasi berapa banyak percakapan yang dihasilkan secara bersamaan.
Aturan penggunaan untuk dewasa
Model ini bersifat terbuka, di-host oleh penyedia independen, dan merespons tanpa penolakan konten untuk penggunaan dewasa yang legal. Siapa pun yang menerbitkan chatbot seperti ini bertanggung jawab atas penggunaannya. Beberapa praktik dasar:
- Verifikasi usia. Wajibkan konfirmasi bahwa pengguna sudah dewasa sebelum percakapan pertama dan cantumkan hal ini dalam ketentuan layanan Anda.
- Larangan anak di bawah umur. Konten seksual yang melibatkan anak di bawah umur dilarang tanpa pengecualian. Blokir persona atau permintaan semacam itu di lapisan Anda.
- Batas per pengguna. Tetapkan batas pesan harian untuk menghindari penyalahgunaan dan pengeluaran yang tidak terduga.
- Privasi. Simpan data seminimal mungkin dan beri tahu apa yang disimpan. Dalam API ini, prompt tidak digunakan untuk pelatihan.
- Hanya teks. API tidak menghasilkan gambar, audio, atau video.
Langkah selanjutnya
Dengan dasar yang sudah siap, peningkatan paling berguna adalah: menyimpan percakapan ke basis data, menampilkan saldo kepada Anda melalui header X-Balance-USD, menggunakan tools agar bot dapat mengakses data Anda, dan mode JSON saat Anda memerlukan output terstruktur. Dokumentasi mencakup setiap fitur. Untuk memahami perubahan saat menghilangkan sensor dari sebuah model dan bagaimana hal itu berkaitan dengan produk Anda, baca AI tanpa filter.
Isi saldo berkisar antara US$ 20 hingga US$ 500, dalam USDT di jaringan TRC20 atau USDC di jaringan Base.
