สถาปัตยกรรมเป็นอย่างไร
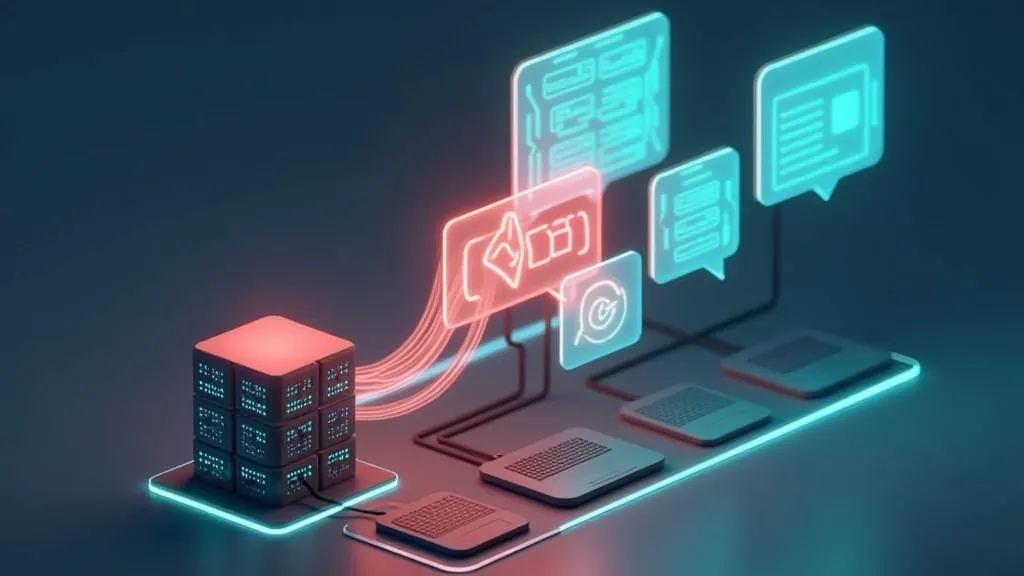
แชทบอทแบบไม่มีตัวกรอง ประกอบด้วยสามส่วน: หน้าจอผู้ใช้ เซิร์ฟเวอร์ของคุณ และ API สำหรับภาษา เซิร์ฟเวอร์เป็นศูนย์กลาง เก็บคีย์ API รักษาประวัติการสนทนาแต่ละครั้ง และตัดสินใจว่าจะส่งข้อมูลไปยังโมเดลอย่างไร หน้าจอจะไม่สื่อสารกับ API โดยตรง เพื่อป้องกันไม่ให้คีย์ถูกเปิดเผย
API นี้เข้ากันได้กับ OpenAI: SDK ทางการใช้งานได้โดยการเปลี่ยน Base URL เป็น https://api.llmsemcensura.com/v1 และใช้โมเดล uncensored หากคุณยังไม่มีคีย์ สร้างที่นี่; การสมัครให้สิทธิ์คุณ US$ 0,50 ของเครดิตทดลองใช้ฟรี เพียงคลิกเดียว
ก่อนสร้างเซิร์ฟเวอร์ ให้ตรวจสอบการเชื่อมต่อด้วยการทดสอบขั้นต่ำใน Python เพื่อตรวจสอบให้แน่ใจว่าคีย์และ URL ถูกต้อง:
from openai import OpenAI
client = OpenAI(base_url="https://api.llmsemcensura.com/v1", api_key="SUA_CHAVE")
r = client.chat.completions.create(
model="uncensored",
messages=[{"role": "user", "content": "Olá, tudo bem?"}],
)
print(r.choices[0].message.content)เซิร์ฟเวอร์ Node พร้อมสตรีมมิง
ตัวอย่างนี้ใช้ Express เพื่อรับข้อความและส่งคำตอบผ่าน SSE (server-sent events) เพื่อให้ข้อความปรากฏทีละน้อยบนหน้าจอ ติดตั้ง dependencies ด้วย npm install express openai และใส่คีย์ใน API_KEY
import express from "express";
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://api.llmsemcensura.com/v1",
apiKey: process.env.API_KEY,
});
const SISTEMA =
"Você é a Lia, uma assistente de conversa direta e bem-humorada. " +
"Responda em português do Brasil. Os usuários são adultos.";
const sessoes = new Map(); // id da sessão -> histórico
const app = express();
app.use(express.json());
app.post("/chat", async (req, res) => {
const { id, mensagem } = req.body;
const historico = sessoes.get(id) ?? [];
historico.push({ role: "user", content: mensagem });
res.setHeader("Content-Type", "text/event-stream");
res.setHeader("Cache-Control", "no-cache");
try {
const stream = await client.chat.completions.create({
model: "uncensored",
messages: [{ role: "system", content: SISTEMA }, ...historico.slice(-12)],
stream: true,
max_tokens: 500,
});
let texto = "";
for await (const chunk of stream) {
const parte = chunk.choices[0]?.delta?.content ?? "";
if (parte) {
texto += parte;
res.write("data: " + JSON.stringify(parte) + "\n\n");
}
}
historico.push({ role: "assistant", content: texto });
sessoes.set(id, historico);
res.write("data: [FIM]\n\n");
} catch (e) {
res.write("data: " + JSON.stringify("erro: tente de novo em instantes") + "\n\n");
}
res.end();
});
app.listen(3000);Body ของคำขอประกอบด้วย id ของเซสชันและ mensagem ข้อผิดพลาดที่พบบ่อยคือการลืมหัวข้อความ Content-Type: application/json ในการเรียกใช้ ซึ่งจะทำให้ body ว่างเปล่าบนเซิร์ฟเวอร์ เมื่อทดสอบผ่านเบราว์เซอร์หรือเครื่องมือส่งคำขอ คุณจะต้องเห็นข้อความที่ค่อยๆ มาทีละส่วนและสุดท้ายคือเครื่องหมาย [FIM]
ประวัติ: สิ่งที่ต้องเก็บและสิ่งที่จะส่ง
API ไม่มีหน่วยความจำของการสนทนา แต่ละคำขอจะส่งข้อความที่โมเดลจำเป็นต้องเห็น ในโค้ดข้างต้น ประวัติการสนทนาทั้งหมดเก็บอยู่ใน Map และจะมีเพียง 12 ข้อความล่าสุดเท่านั้นที่ถูกส่งไปยัง API (historico.slice(-12))
เหตุผลในการตัดข้อความ
หากไม่ตัดข้อความ ขนาดข้อมูลขาเข้าจะเพิ่มขึ้นในทุกๆ รอบและทำให้ต้นทุนสูงขึ้น ด้วยหน้าต่างบริบทที่รองรับ 100.000 โทเคน การสนทนาที่ยาวมากอาจบรรจุได้ทั้งหมด แต่จะมีต้นทุนสูงและทำงานช้าลงโดยไม่ได้ประโยชน์ที่สอดคล้องกัน
พรอมต์ระบบ
มันกำหนดตัวตนและวิธีการพูดของบอท พรอมต์ที่กระชับและเจาะจงจะทำงานได้ดีกว่ารายการข้อห้ามหรือข้อกำหนดที่ยาวนาน ให้ระบุภาษา น้ำเสียง ขนาดเฉลี่ยของคำตอบ และกลุ่มเป้าหมาย แต่ละโทเคนในพรอมต์ระบบจะถูกส่งใหม่ในทุกคำขอ ดังนั้นพรอมต์ขนาด 250 โทเคนจึงมีต้นทุนต่ำกว่า 2,000 โทเคนมาก ควรทดสอบการเปลี่ยนแปลงทีละรายการและบันทึกเวอร์ชันที่ใช้งานได้ดี
หน่วยความจำระยะยาว
หากการสนทนาจำเป็นต้องจดจำข้อเท็จจริงในอดีต ให้สั่งให้โมเดลสรุปย่อเป็นระยะและวางผลลัพธ์นั้นต่อจากพรอมต์ระบบ ในสภาพแวดล้อมการผลิต ให้เปลี่ยนจาก Map เป็นฐานข้อมูล เนื่องจาก Map จะถูกรีเซ็ตเมื่อเซิร์ฟเวอร์รีสตาร์ทและไม่สามารถแบ่งปันสถานะระหว่างหลายอินสแตนซ์ได้
ต้นทุนต่อข้อความ
ราคาอยู่ที่ US$ 0,15 ต่อ 1M โทเคนขาเข้าและ US$ 0,50 ต่อ 1M โทเคนขาออก สมมติฐานของตัวอย่าง: พรอมต์ระบบ 250 โทเคน, ข้อความผู้ใช้ 80, คำตอบ 300 และ 12 ข้อความในประวัติ (ฝั่งละ 6 ข้อความ)
- ประวัติ: 6 x 80 + 6 x 300 = 2.280 โทเคน
- ขาเข้า: 250 + 2.280 + 80 = 2.610 โทเคน หรือ US$ 0,0003915
- ขาออก: 300 โทเคน หรือ US$ 0,00015
- รวม: US$ 0,0005415 ต่อข้อความ
ข้อความ 1,000 ข้อความมีค่าใช้จ่ายประมาณ US$ 0,54 เครดิตทดลองใช้ US$ 0,50 ใช้ได้ประมาณ 923 ข้อความ และการเติมเงิน US$ 20 ครอบคลุมประมาณ 36.900 ข้อความ เพื่อดูระดับการเติมเงินและโบนัส ให้เปิด ราคา การเรียกใช้ที่ล้มเหลวหรือถูกปฏิเสธจะไม่ถูกเรียกเก็บเงิน
ขีดจำกัด, 429 และคิว
คีย์เต็มรูปแบบรองรับคำขอพร้อมกัน 8 คำขอและ 300 คำขอต่อนาที ส่วนคีย์ทดลองรองรับ 2 คำขอและ 60 คำขอต่อนาที เมื่อแชทยอดนิยมเกินขีดจำกัด API จะตอบกลับด้วย HTTP 429 พร้อมโค้ด rate_limited หรือ concurrency ในกรณีโหลดเกินชั่วคราว 429 จะมาพร้อม Retry-After: 5 โปรดจำไว้ว่าคำตอบแบบสตรีมมิงจะครอบครองช่องว่างจนกว่าจะเสร็จสิ้น ดังนั้นคำตอบที่ยาวจะกักการเรียกใช้พร้อมกันนานขึ้น
ฟังก์ชัน retry แบบง่ายจะเคารพช่วงเวลาดังกล่าว:
async function comRetry(fn, tentativas = 3) {
for (let i = 0; i < tentativas; i++) {
try {
return await fn();
} catch (e) {
if (e.status === 429 && i < tentativas - 1) {
await new Promise((r) => setTimeout(r, 5000)); // Retry-After: 5
continue;
}
throw e;
}
}
}สำหรับผู้ใช้จำนวนมากที่ใช้งานพร้อมกัน ให้ติดตั้งคิวที่ฝั่งเซิร์ฟเวอร์และจำกัดจำนวนการสนทนาที่เกิดขึ้นพร้อมกัน
กฎการใช้งานสำหรับผู้ใหญ่
โมเดลเป็นแบบเปิด โฮสต์โดยผู้ให้บริการอิสระ และตอบสนองโดยไม่ปฏิเสธเนื้อหาสำหรับการใช้งานผู้ใหญ่ที่ถูกต้องตามกฎหมาย ผู้ที่เผยแพร่แชทบอทลักษณะนี้ต้องรับผิดชอบต่อการใช้งานนั้น หลักการพื้นฐานบางประการมีดังนี้:
- การตรวจสอบอายุ. กำหนดให้ผู้ใช้ยืนยันว่าตนเองเป็นผู้ใหญ่ก่อนเริ่มการสนทนาครั้งแรก และระบุเงื่อนไขนี้ไว้ในข้อกำหนดการให้บริการของคุณ
- ห้ามเนื้อหาที่เกี่ยวข้องกับผู้เยาว์ เนื้อหาทางเพศที่เกี่ยวข้องกับผู้เยาว์เป็นสิ่งที่ห้ามโดยเด็ดขาด ห้ามมีข้อยกเว้น ให้บล็อกที่เลเยอร์ของคุณสำหรับบุคลิกหรือคำขอที่เกี่ยวข้องกับประเด็นนี้
- ขีดจำกัดต่อผู้ใช้ กำหนดเพดานข้อความรายวันเพื่อป้องกันการละเมิดและการใช้จ่ายที่ไม่คาดคิด
- ความเป็นส่วนตัว เก็บข้อมูลให้น้อยที่สุดและแจ้งสิ่งที่จัดเก็บ ใน API นี้ พรอมต์ไม่ถูกนำไปใช้สำหรับการฝึกโมเดล
- เฉพาะข้อความ API นี้ไม่สร้างภาพ เสียง หรือวิดีโอ
ขั้นตอนถัดไป
เมื่อพื้นฐานพร้อมแล้ว การปรับปรุงที่มีประโยชน์ที่สุดได้แก่: บันทึกการสนทนาในฐานข้อมูล แสดงยอดคงเหลือให้คุณผ่านส่วนหัว X-Balance-USD ใช้ tools เพื่อให้บอทสอบถามข้อมูลของคุณ และโหมด JSON เมื่อต้องการผลลัพธ์ที่มีโครงสร้าง เอกสาร ครอบคลุมฟีเจอร์แต่ละรายการ เพื่อทำความเข้าใจสิ่งที่เปลี่ยนแปลงเมื่อเอาการเซ็นเซอร์ออกจากโมเดลและวิธีที่สิ่งนี้เกี่ยวข้องกับผลิตภัณฑ์ของคุณ ให้อ่าน AI ไม่มีตัวกรอง
การเติมเงินมีตั้งแต่ US$ 20 ถึง US$ 500 โดยชำระเป็น USDT บนเครือข่าย TRC20 หรือ USDC บนเครือข่าย Base
