Com'è fatta l'architettura
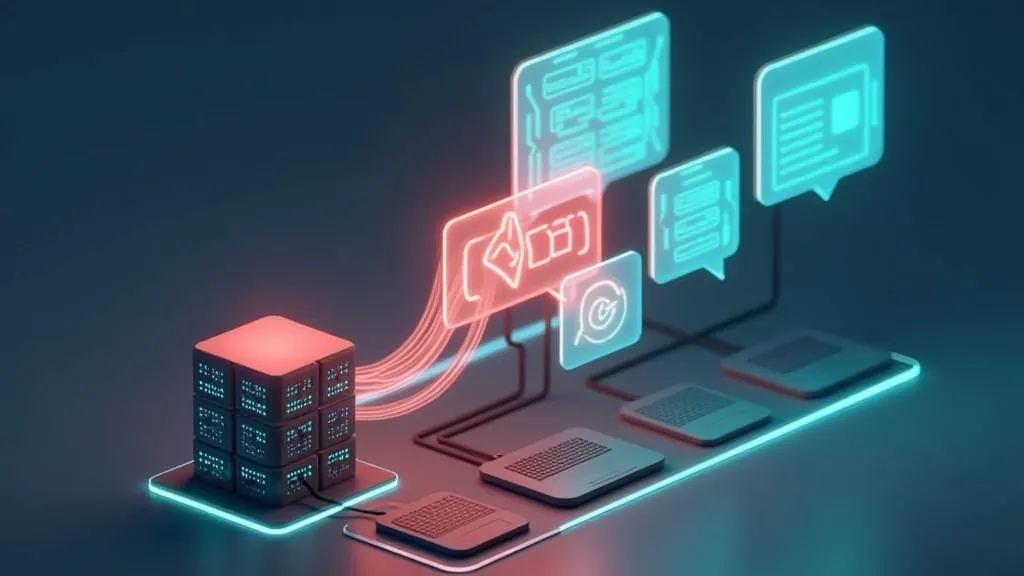
Un chatbot senza filtri personalizzato ha tre componenti: l'interfaccia utente, un tuo server e l'API di linguaggio. Il server è il centro. Conserva la chiave API, mantiene la cronologia di ogni conversazione e decide cosa inviare al modello. L'interfaccia non parla mai direttamente con l'API, perché questo esporrebbe la chiave.
Questa API è compatibile con OpenAI: l'SDK ufficiale funziona cambiando la base URL in https://api.llmsemcensura.com/v1 e usando il modello uncensored. Se non hai ancora una chiave, creane una qui; la registrazione ti dà diritto a US$ 0,50 di credito di prova, con un clic.
Prima di montare il server, valida la connessione con un test minimo in Python, solo per assicurarti che chiave e URL siano corretti:
from openai import OpenAI
client = OpenAI(base_url="https://api.llmsemcensura.com/v1", api_key="SUA_CHAVE")
r = client.chat.completions.create(
model="uncensored",
messages=[{"role": "user", "content": "Olá, tudo bem?"}],
)
print(r.choices[0].message.content)Il server in Node, con streaming
L'esempio usa Express per ricevere il messaggio e restituire la risposta tramite SSE (server-sent events), in modo che il testo appaia gradualmente sullo schermo. Installa le dipendenze con npm install express openai e inserisci la chiave in API_KEY.
import express from "express";
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://api.llmsemcensura.com/v1",
apiKey: process.env.API_KEY,
});
const SISTEMA =
"Você é a Lia, uma assistente de conversa direta e bem-humorada. " +
"Responda em português do Brasil. Os usuários são adultos.";
const sessoes = new Map(); // id da sessão -> histórico
const app = express();
app.use(express.json());
app.post("/chat", async (req, res) => {
const { id, mensagem } = req.body;
const historico = sessoes.get(id) ?? [];
historico.push({ role: "user", content: mensagem });
res.setHeader("Content-Type", "text/event-stream");
res.setHeader("Cache-Control", "no-cache");
try {
const stream = await client.chat.completions.create({
model: "uncensored",
messages: [{ role: "system", content: SISTEMA }, ...historico.slice(-12)],
stream: true,
max_tokens: 500,
});
let texto = "";
for await (const chunk of stream) {
const parte = chunk.choices[0]?.delta?.content ?? "";
if (parte) {
texto += parte;
res.write("data: " + JSON.stringify(parte) + "\n\n");
}
}
historico.push({ role: "assistant", content: texto });
sessoes.set(id, historico);
res.write("data: [FIM]\n\n");
} catch (e) {
res.write("data: " + JSON.stringify("erro: tente de novo em instantes") + "\n\n");
}
res.end();
});
app.listen(3000);Il corpo della richiesta contiene un id di sessione e la messaggio. Un errore comune è dimenticare l’intestazione Content-Type: application/json nella chiamata, il che lascia il corpo vuoto sul server. Testando dal browser o tramite uno strumento di richieste, vedrai i frammenti arrivare uno alla volta e, alla fine, il marcatore [FIM].
Cronologia: cosa conservare e cosa inviare
L'API non ha memoria della conversazione. Ogni chiamata porta i messaggi che il modello deve vedere. Nel codice sopra, la cronologia completa resta nel Map e solo le ultime 12 messaggi seguono verso l'API (historico.slice(-12)).
Perché tagliare
Senza taglio, l'input cresce a ogni turno e il costo sale insieme. Con una finestra di contesto di 100.000 token, una conversazione molto lunga potrebbe anche entrare tutta, ma sarebbe costosa e lenta senza un guadagno proporzionale.
Il prompt di sistema
Definisce chi è il bot e come parla. Prompt brevi e specifici funzionano meglio di lunghe liste di divieti e richieste. Indica la lingua, il tono, la lunghezza media delle risposte e il pubblico. Ogni token del prompt di sistema viene reinviato in ogni chiamata, quindi 250 token costano molto meno di 2.000. Testa le modifiche una alla volta e conserva le versioni funzionanti.
Memoria a lungo termine
Se la conversazione deve ricordare fatti passati, chiedi al modello di volta in volta un breve riepilogo e inseriscilo subito dopo il prompt di sistema. In produzione, sostituisci il Map con un database, perché si azzera quando il server si riavvia e non condivide lo stato tra più istanze.
Quanto costa ogni messaggio
Il prezzo è US$ 0,15 per 1M di token di input e US$ 0,50 per 1M di output. Premesse dell'esempio: prompt di sistema di 250 token, messaggio utente di 80, risposta di 300 e 12 messaggi di cronologia (6 da ogni lato).
- Cronologia: 6 x 80 + 6 x 300 = 2.280 token
- Input: 250 + 2.280 + 80 = 2.610 token, pari a US$ 0,0003915
- Output: 300 token, pari a US$ 0,00015
- Totale: US$ 0,0005415 per messaggio
Mille messaggi costano circa US$ 0,54. Il credito di prova di US$ 0,50 rende circa 923 messaggi, e una ricarica di US$ 20 copre circa 36.900. Per vedere le fasce di ricarica e i bonus, apri prezzi. Le chiamate fallite o rifiutate non vengono addebitate.
Limiti, 429 e code
La chiave completa accetta 8 richieste simultanee e 300 al minuto; quella di prova, 2 e 60. Quando un chat popolare supera questi limiti, l'API risponde con HTTP 429 e il codice rate_limited o concurrency. In caso di sovraccarico temporaneo, il 429 include Retry-After: 5. Ricorda che una risposta in streaming occupa la posizione fino alla fine del flusso, quindi le risposte lunghe trattengono la concorrenza per più tempo.
Una funzione di retry semplice rispetta questo intervallo:
async function comRetry(fn, tentativas = 3) {
for (let i = 0; i < tentativas; i++) {
try {
return await fn();
} catch (e) {
if (e.status === 429 && i < tentativas - 1) {
await new Promise((r) => setTimeout(r, 5000)); // Retry-After: 5
continue;
}
throw e;
}
}
}Per molti utenti contemporaneamente, inserisci una coda nel server e limita quante conversazioni avvengono simultaneamente.
Regole per l'uso adulto
Il modello è open-weight, ospitato da un provider indipendente e risponde senza rifiutare contenuti per uso adulto legale. Chi pubblica un chatbot di questo tipo si assume la responsabilità dell'uso. Alcune pratiche di base:
- Verifica dell'età. Richiedi la conferma che l'utente sia maggiorenne prima della prima chat e inseriscilo nei termini del tuo servizio.
- Divieto ai minori. I contenuti sessuali che coinvolgono minori sono vietati, senza eccezioni. Blocca nel tuo livello qualsiasi persona o richiesta in tal senso.
- Limite per utente. Definisci un tetto giornaliero di messaggi per evitare abusi e spese impreviste.
- Privacy. Conserva il minimo necessario e informa su cosa viene memorizzato. In questa API, i prompt non vengono utilizzati per l'addestramento.
- Solo testo. L'API non genera immagini, audio né video.
Prossimi passi
Con le basi pronte, i miglioramenti più utili sono: salvare le conversazioni in un database, mostrare il saldo a te tramite l'intestazione X-Balance-USD, usare tools per far sì che il bot interroghi i tuoi dati e la modalità JSON quando serve un'uscita strutturata. La documentazione copre ogni funzionalità. Per capire cosa cambia rimuovendo i filtri da un modello e come questo si collega al tuo prodotto, leggi IA senza filtro.
Le ricariche vanno da US$ 20 a US$ 500, in USDT sulla rete TRC20 o USDC sulla rete Base.
