Como é a arquitetura
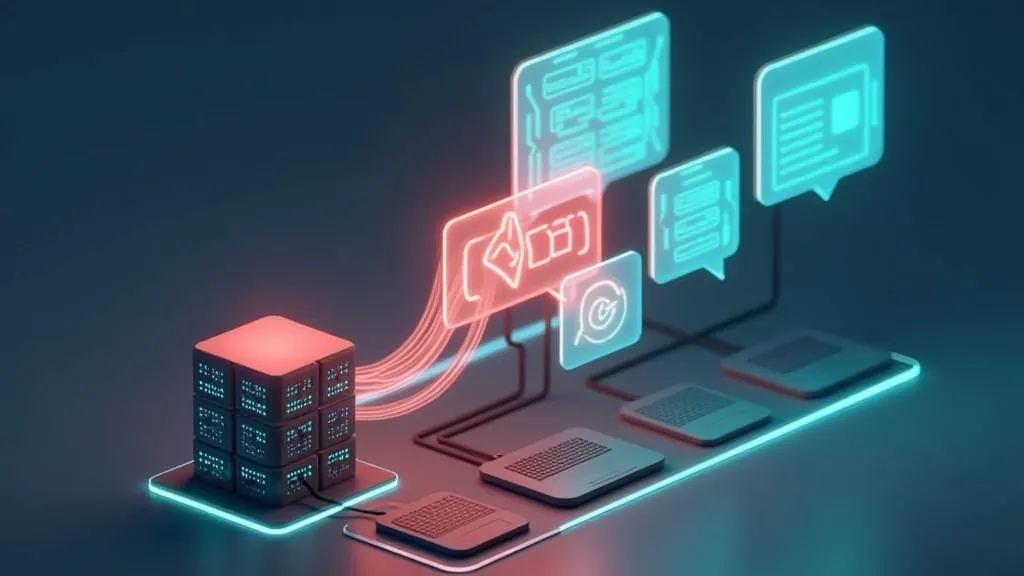
Um chatbot sem filtro próprio tem três peças: a tela do usuário, um servidor seu e a API de linguagem. O servidor é o centro. Ele guarda a chave de API, mantém o histórico de cada conversa e decide o que enviar ao modelo. A tela nunca fala direto com a API, porque isso exporia a chave.
Esta API é compatível com a OpenAI: o SDK oficial funciona trocando a base URL para https://api.llmsemcensura.com/v1 e usando o modelo uncensored. Se você ainda não tem chave, crie uma aqui; o cadastro dá direito a US$ 0,50 de crédito de teste, com um clique.
Antes de montar o servidor, valide a conexão com um teste mínimo em Python, só para ter certeza de que chave e URL estão certas:
from openai import OpenAI
client = OpenAI(base_url="https://api.llmsemcensura.com/v1", api_key="SUA_CHAVE")
r = client.chat.completions.create(
model="uncensored",
messages=[{"role": "user", "content": "Olá, tudo bem?"}],
)
print(r.choices[0].message.content)O servidor em Node, com streaming
O exemplo usa Express para receber a mensagem e devolver a resposta por SSE (server-sent events), de modo que o texto aparece aos poucos na tela. Instale as dependências com npm install express openai e coloque a chave em API_KEY.
import express from "express";
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://api.llmsemcensura.com/v1",
apiKey: process.env.API_KEY,
});
const SISTEMA =
"Você é a Lia, uma assistente de conversa direta e bem-humorada. " +
"Responda em português do Brasil. Os usuários são adultos.";
const sessoes = new Map(); // id da sessão -> histórico
const app = express();
app.use(express.json());
app.post("/chat", async (req, res) => {
const { id, mensagem } = req.body;
const historico = sessoes.get(id) ?? [];
historico.push({ role: "user", content: mensagem });
res.setHeader("Content-Type", "text/event-stream");
res.setHeader("Cache-Control", "no-cache");
try {
const stream = await client.chat.completions.create({
model: "uncensored",
messages: [{ role: "system", content: SISTEMA }, ...historico.slice(-12)],
stream: true,
max_tokens: 500,
});
let texto = "";
for await (const chunk of stream) {
const parte = chunk.choices[0]?.delta?.content ?? "";
if (parte) {
texto += parte;
res.write("data: " + JSON.stringify(parte) + "\n\n");
}
}
historico.push({ role: "assistant", content: texto });
sessoes.set(id, historico);
res.write("data: [FIM]\n\n");
} catch (e) {
res.write("data: " + JSON.stringify("erro: tente de novo em instantes") + "\n\n");
}
res.end();
});
app.listen(3000);O corpo da requisição traz um id de sessão e a mensagem. Um erro frequente é esquecer o cabeçalho Content-Type: application/json na chamada, o que deixa o corpo vazio no servidor. Testando pelo navegador ou por uma ferramenta de requisições, você deve ver os trechos chegando um a um e, no fim, o marcador [FIM].
Histórico: o que guardar e o que enviar
A API não tem memória de conversa. Cada chamada leva as mensagens que o modelo precisa ver. No código acima, o histórico completo fica no Map e só as últimas 12 mensagens seguem para a API (historico.slice(-12)).
Por que cortar
Sem corte, a entrada cresce a cada rodada e o custo sobe junto. Com a janela de 100.000 tokens, uma conversa muito longa até caberia inteira, mas seria cara e lenta sem ganho proporcional.
O prompt de sistema
Ele define quem o bot é e como fala. Prompts curtos e específicos funcionam melhor que listas longas de proibições e exigências. Diga o idioma, o tom, o tamanho médio das respostas e o público. Cada token do prompt de sistema é reenviado em toda chamada, então 250 tokens custam bem menos que 2.000. Teste mudanças uma de cada vez e guarde as versões que funcionaram.
Memória de longo prazo
Se a conversa precisa lembrar fatos antigos, peça ao modelo, de vez em quando, um resumo curto e coloque-o logo depois do prompt de sistema. Em produção, troque o Map por um banco de dados, porque ele zera quando o servidor reinicia e não divide estado entre várias instâncias.
Quanto custa cada mensagem
O preço é US$ 0,15 por 1M de tokens de entrada e US$ 0,50 por 1M de saída. Premissas do exemplo: prompt de sistema de 250 tokens, mensagem do usuário de 80, resposta de 300 e 12 mensagens de histórico (6 de cada lado).
- Histórico: 6 x 80 + 6 x 300 = 2.280 tokens
- Entrada: 250 + 2.280 + 80 = 2.610 tokens, ou US$ 0,0003915
- Saída: 300 tokens, ou US$ 0,00015
- Total: US$ 0,0005415 por mensagem
Mil mensagens custam cerca de US$ 0,54. O crédito de teste de US$ 0,50 rende em torno de 923 mensagens, e uma recarga de US$ 20 cobre cerca de 36.900. Para ver as faixas de recarga e os bônus, abra preços. Chamadas com falha ou recusadas não são cobradas.
Limites, 429 e filas
A chave completa aceita 8 requisições ao mesmo tempo e 300 por minuto; a de teste, 2 e 60. Quando um chat popular passa disso, a API responde HTTP 429 com o código rate_limited ou concurrency. Em sobrecarga temporária, o 429 vem com Retry-After: 5. Lembre que uma resposta em streaming ocupa a vaga até o fim do fluxo, então respostas longas seguram a concorrência por mais tempo.
Uma função de retry simples respeita esse intervalo:
async function comRetry(fn, tentativas = 3) {
for (let i = 0; i < tentativas; i++) {
try {
return await fn();
} catch (e) {
if (e.status === 429 && i < tentativas - 1) {
await new Promise((r) => setTimeout(r, 5000)); // Retry-After: 5
continue;
}
throw e;
}
}
}Para muitos usuários ao mesmo tempo, coloque uma fila no servidor e limite quantas conversas geram ao mesmo tempo.
Regras de uso para adultos
O modelo é aberto, hospedado por um provedor independente e responde sem recusas de conteúdo para uso adulto legal. Quem publica um chatbot assim assume a responsabilidade pelo uso. Algumas práticas básicas:
- Verificação de idade. Exija a confirmação de que o usuário é maior de idade antes da primeira conversa e deixe isso nos termos do seu serviço.
- Proibição de menores. Conteúdo sexual envolvendo menores é proibido, sem exceção. Bloqueie na sua camada qualquer persona ou pedido nesse sentido.
- Limite por usuário. Defina um teto diário de mensagens para evitar abuso e gasto inesperado.
- Privacidade. Guarde o mínimo necessário e avise o que é armazenado. Nesta API, os prompts não são usados para treinamento.
- Só texto. A API não gera imagem, áudio nem vídeo.
Próximos passos
Com a base pronta, as melhorias mais úteis são: salvar conversas em banco, mostrar o saldo para você pelo cabeçalho X-Balance-USD, usar tools para o bot consultar dados seus e o modo JSON quando precisar de saída estruturada. A documentação cobre cada recurso. Para entender o que muda ao tirar filtros de um modelo e como isso se relaciona com o seu produto, leia IA sem filtro.
As recargas vão de US$ 20 a US$ 500, em USDT na rede TRC20 ou USDC na rede Base.
