Hoe ziet de architectuur eruit
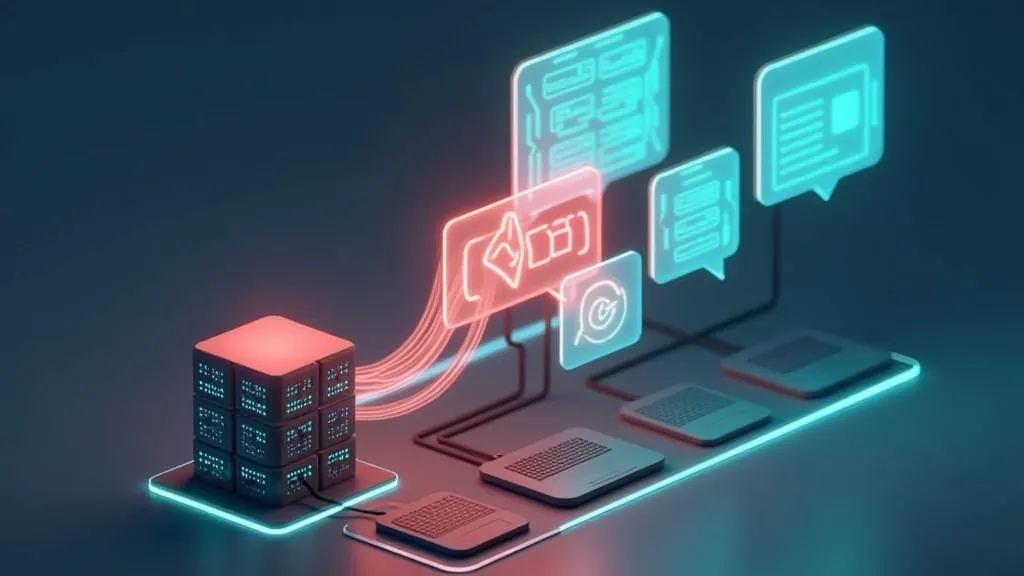
Een eigen chatbot zonder filters heeft drie onderdelen: het gebruikersscherm, je eigen server en de taal-API. De server is het centrum. Hij bewaart de API-sleutel, houdt de geschiedenis van elk gesprek bij en beslist wat naar het model wordt gestuurd. Het scherm spreekt nooit direct met de API, omdat dat de sleutel zou onthullen.
Deze API is compatibel met OpenAI: de officiële SDK werkt door de base URL aan te passen naar https://api.llmsemcensura.com/v1 en het model uncensored te gebruiken. Heb je nog geen sleutel, maak er dan hier een aan; registratie geeft recht op US$ 0,50 aan testtegoed, met één klik.
Voordat je de server bouwt, valider je de verbinding met een minimale test in Python, puur om zeker te weten dat sleutel en URL kloppen:
from openai import OpenAI
client = OpenAI(base_url="https://api.llmsemcensura.com/v1", api_key="SUA_CHAVE")
r = client.chat.completions.create(
model="uncensored",
messages=[{"role": "user", "content": "Olá, tudo bem?"}],
)
print(r.choices[0].message.content)De Node-server met streaming
Het voorbeeld gebruikt Express om de boodschap te ontvangen en het antwoord via SSE (server-sent events) terug te sturen, zodat de tekst geleidelijk op het scherm verschijnt. Installeer de afhankelijkheden met npm install express openai en zet de sleutel in API_KEY.
import express from "express";
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://api.llmsemcensura.com/v1",
apiKey: process.env.API_KEY,
});
const SISTEMA =
"Você é a Lia, uma assistente de conversa direta e bem-humorada. " +
"Responda em português do Brasil. Os usuários são adultos.";
const sessoes = new Map(); // id da sessão -> histórico
const app = express();
app.use(express.json());
app.post("/chat", async (req, res) => {
const { id, mensagem } = req.body;
const historico = sessoes.get(id) ?? [];
historico.push({ role: "user", content: mensagem });
res.setHeader("Content-Type", "text/event-stream");
res.setHeader("Cache-Control", "no-cache");
try {
const stream = await client.chat.completions.create({
model: "uncensored",
messages: [{ role: "system", content: SISTEMA }, ...historico.slice(-12)],
stream: true,
max_tokens: 500,
});
let texto = "";
for await (const chunk of stream) {
const parte = chunk.choices[0]?.delta?.content ?? "";
if (parte) {
texto += parte;
res.write("data: " + JSON.stringify(parte) + "\n\n");
}
}
historico.push({ role: "assistant", content: texto });
sessoes.set(id, historico);
res.write("data: [FIM]\n\n");
} catch (e) {
res.write("data: " + JSON.stringify("erro: tente de novo em instantes") + "\n\n");
}
res.end();
});
app.listen(3000);De request body bevat een id van de sessie en de mensagem. Een veelgemaakte fout is de header Content-Type: application/json vergeten bij de call, waardoor de body op de server leeg blijft. Via de browser of een request tool zie je de chunks één voor één binnenkomen en aan het eind de marker [FIM].
Geschiedenis: wat bewaren en wat versturen
De API heeft geen gespreksgeheugen. Elke aanroep bevat de berichten die het model nodig heeft. In de bovenstaande code blijft de volledige geschiedenis in de Map staan en worden alleen de laatste 12 berichten naar de API gestuurd (historico.slice(-12)).
Waarafsnijden?
Zonder afsnijden groeit de invoer bij elke ronde en stijgen de kosten mee. Met een contextvenster van 100.000 tokens zou een zeer lang gesprek weliswaar volledig passen, maar dat zou duur en traag zijn zonder evenredig voordeel.
De systeemprompt
Deze bepaalt wie de bot is en hoe hij spreekt. Korte, specifieke prompts werken beter dan lange lijsten met verboden en eisen. Vermeld de taal, de toon, de gemiddelde lengte van antwoorden en het publiek. Elke token van de systeemprompt wordt bij elke aanroep opnieuw verstuurd, dus 250 tokens kosten veel minder dan 2.000. Test wijzigingen één voor één en bewaar de versies die werken.
Lange termijngeheugen
Als het gesprek zich oude feiten moet herinneren, vraag het model dan af en toe om een korte samenvatting en voeg deze direct achter de systeemprompt in. In productie vervang je de Map door een database, omdat deze leeg wordt bij een serverherstart en geen status deelt tussen meerdere instanties.
Wat kost elk bericht
De prijs is US$ 0,15 per 1M invoertokens en US$ 0,50 per 1M uitvoertokens. Aannames van het voorbeeld: systeemprompt van 250 tokens, gebruikersboodschap van 80 tokens, antwoord van 300 tokens en 12 berichten geschiedenis (6 aan elke kant).
- Geschiedenis: 6 x 80 + 6 x 300 = 2.280 tokens
- Invoer: 250 + 2.280 + 80 = 2.610 tokens, oftewel US$ 0,0003915
- Uitvoer: 300 tokens, oftewel US$ 0,00015
- Totaal: US$ 0,0005415 per bericht
Duizend berichten kosten ongeveer US$ 0,54. Het testtegoed van US$ 0,50 is goed voor ongeveer 923 berichten, en een opwaardering van US$ 20 dekt ongeveer 36.900. Om de opwaardeertiers en bonusen te zien, open prijzen. Mislukte of afgewezen aanroepen worden niet in rekening gebracht.
Limieten, 429 en wachtrijen
De volledige sleutel accepteert 8 gelijktijdige verzoeken en 300 per minuut; de testsleutel, 2 en 60. Wanneer een populaire chatbot daarboven gaat, antwoordt de API met HTTP 429 en de code rate_limited of concurrency. Bij tijdelijke overbelasting komt de 429 met Retry-After: 5. Houd er rekening mee dat een streaming-antwoord de plek bezet tot het einde van de stroom, dus lange antwoorden houden de concurrency langer vast.
Een eenvoudige retry-functie respecteert dit interval:
async function comRetry(fn, tentativas = 3) {
for (let i = 0; i < tentativas; i++) {
try {
return await fn();
} catch (e) {
if (e.status === 429 && i < tentativas - 1) {
await new Promise((r) => setTimeout(r, 5000)); // Retry-After: 5
continue;
}
throw e;
}
}
}Voor veel gebruikers tegelijk plaats je een wachtrij op de server en beperk je hoeveel gesprekken er gelijktijdig worden gegenereerd.
Gebruiksregels voor volwassenen
Het model is open, gehost door een onafhankelijke provider en geeft antwoorden zonder inhoudsfilters voor legaal volwassen gebruik. Wie een chatbot zoals deze publiceert, is zelf verantwoordelijk voor het gebruik. Enkele basispraktijken:
- Leeftijdsverificatie. Vraag bevestiging dat de gebruiker meerderjarig is vóór het eerste gesprek en neem dit op in de servicevoorwaarden.
- Verbod op minderjarigen. Seksuele inhoud met minderjarigen is verboden, zonder uitzondering. Blokkeer op jouw laag elke persona of vraag die hierop betrekking heeft.
- Limiet per gebruiker. Stel een dagelijkse limiet voor berichten in om misbruik en onverwachte kosten te voorkomen.
- Privacy. Bewaar alleen het noodzakelijke en geef aan wat wordt opgeslagen. Bij deze API worden prompts niet gebruikt voor training.
- Alleen tekst. De API genereert geen afbeeldingen, audio of video.
Volgende stappen
Met de basis op orde, zijn de meest nuttige verbeteringen: gesprekken opslaan in een database, het saldo tonen via de header X-Balance-USD, tools gebruiken om de bot jouw gegevens te laten opvragen, en de JSON-modus wanneer gestructureerde uitvoer nodig is. De documentatie behandelt elk onderdeel. Om te begrijpen wat er verandert als je filters van een model verwijdert en hoe dit samenhangt met jouw product, lees AI zonder filter.
Opwaarderingen variëren van US$ 20 tot US$ 500, in USDT op het TRC20-netwerk of USDC op het Base-netwerk.
