Cómo es la arquitectura
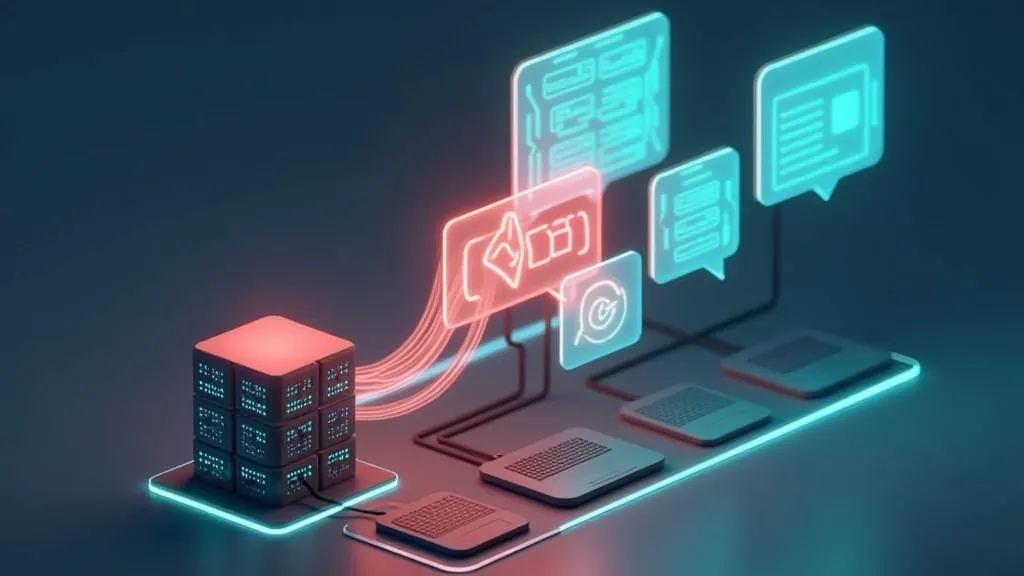
Un chatbot sin filtro propio tiene tres partes: la pantalla del usuario, tu servidor y la API de lenguaje. El servidor es el centro. Guarda la clave de API, mantiene el historial de cada conversación y decide qué enviar al modelo. La pantalla nunca habla directamente con la API, porque eso expondría la clave.
Esta API es compatible con OpenAI: el SDK oficial funciona cambiando la base URL a https://api.llmsemcensura.com/v1 y usando el modelo uncensored. Si aún no tienes clave, créala aquí; el registro da derecho a US$ 0,50 de crédito de prueba, con un clic.
Antes de montar el servidor, valida la conexión con una prueba mínima en Python, solo para asegurarte de que la clave y la URL son correctas:
from openai import OpenAI
client = OpenAI(base_url="https://api.llmsemcensura.com/v1", api_key="SUA_CHAVE")
r = client.chat.completions.create(
model="uncensored",
messages=[{"role": "user", "content": "Olá, tudo bem?"}],
)
print(r.choices[0].message.content)El servidor en Node, con streaming
El ejemplo usa Express para recibir el mensaje y devolver la respuesta por SSE (server-sent events), de modo que el texto aparece poco a poco en la pantalla. Instala las dependencias con npm install express openai y coloca la clave en API_KEY.
import express from "express";
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://api.llmsemcensura.com/v1",
apiKey: process.env.API_KEY,
});
const SISTEMA =
"Você é a Lia, uma assistente de conversa direta e bem-humorada. " +
"Responda em português do Brasil. Os usuários são adultos.";
const sessoes = new Map(); // id da sessão -> histórico
const app = express();
app.use(express.json());
app.post("/chat", async (req, res) => {
const { id, mensagem } = req.body;
const historico = sessoes.get(id) ?? [];
historico.push({ role: "user", content: mensagem });
res.setHeader("Content-Type", "text/event-stream");
res.setHeader("Cache-Control", "no-cache");
try {
const stream = await client.chat.completions.create({
model: "uncensored",
messages: [{ role: "system", content: SISTEMA }, ...historico.slice(-12)],
stream: true,
max_tokens: 500,
});
let texto = "";
for await (const chunk of stream) {
const parte = chunk.choices[0]?.delta?.content ?? "";
if (parte) {
texto += parte;
res.write("data: " + JSON.stringify(parte) + "\n\n");
}
}
historico.push({ role: "assistant", content: texto });
sessoes.set(id, historico);
res.write("data: [FIM]\n\n");
} catch (e) {
res.write("data: " + JSON.stringify("erro: tente de novo em instantes") + "\n\n");
}
res.end();
});
app.listen(3000);El cuerpo de la petición incluye un id de sesión y la mensagem. Un error común es olvidar el encabezado Content-Type: application/json en la llamada, lo que deja el cuerpo vacío en el servidor. Probando desde el navegador o una herramienta de peticiones, verás que los fragmentos llegan uno a uno y, al final, el marcador [FIM].
Historial: qué guardar y qué enviar
La API no tiene memoria de conversación. Cada petición lleva los mensajes que el modelo necesita ver. En el código anterior, el historial completo está en el Map y solo las últimas 12 mensajes van a la API (historico.slice(-12)).
Por qué cortar
Sin corte, la entrada crece en cada ronda y el costo sube junto. Con la ventana de 100.000 tokens, una conversación muy larga hasta cabría entera, pero sería cara y lenta sin ganancia proporcional.
El prompt de sistema
El prompt define quién es el bot y cómo habla. Los prompts cortos y específicos funcionan mejor que listas largas de prohibiciones y exigencias. Di el idioma, el tono, el tamaño medio de las respuestas y el público. Cada token del prompt de sistema se reenvía en cada petición, así que 250 tokens cuestan mucho menos que 2.000. Prueba cambios uno por uno y guarda las versiones que funcionaron.
Memoria a largo plazo
Si la conversación necesita recordar hechos antiguos, pide al modelo, de vez en cuando, un resumen corto y colócalo justo después del prompt de sistema. En producción, reemplaza el Map por una base de datos, porque se borra cuando el servidor reinicia y no comparte estado entre varias instancias.
Cuánto cuesta cada mensaje
El precio es US$ 0,15 por 1M de tokens de entrada y US$ 0,50 por 1M de salida. Suposiciones del ejemplo: prompt de sistema de 250 tokens, mensaje del usuario de 80, respuesta de 300 y 12 mensajes de historial (6 de cada lado).
- Historial: 6 x 80 + 6 x 300 = 2.280 tokens
- Entrada: 250 + 2.280 + 80 = 2.610 tokens, o US$ 0,0003915
- Salida: 300 tokens, o US$ 0,00015
- Total: US$ 0,0005415 por mensaje
Mil mensajes cuestan alrededor de US$ 0,54. El crédito de prueba de US$ 0,50 rinde alrededor de 923 mensajes, y una recarga de US$ 20 cubre alrededor de 36.900. Para ver los rangos de recarga y las bonificaciones, abre precios. Las peticiones fallidas o rechazadas no se cobran.
Límites, 429 y colas
La clave completa acepta 8 peticiones al mismo tiempo y 300 por minuto; la de prueba, 2 y 60. Cuando un chat popular supera esto, la API responde HTTP 429 con el código rate_limited o concurrency. En sobrecarga temporal, el 429 viene con Retry-After: 5. Recuerda que una respuesta en streaming ocupa el lugar hasta el final del flujo, así que las respuestas largas retienen la concurrencia por más tiempo.
Una función de reintento simple respeta este intervalo:
async function comRetry(fn, tentativas = 3) {
for (let i = 0; i < tentativas; i++) {
try {
return await fn();
} catch (e) {
if (e.status === 429 && i < tentativas - 1) {
await new Promise((r) => setTimeout(r, 5000)); // Retry-After: 5
continue;
}
throw e;
}
}
}Para muchos usuarios al mismo tiempo, coloca una cola en el servidor y limita cuántas conversaciones se generan al mismo tiempo.
Normas de uso para adultos
El modelo es abierto, está alojado por un proveedor independiente y responde sin rechazos de contenido para uso adulto legal. Quien publica un chatbot así asume la responsabilidad por su uso. Algunas prácticas básicas:
- Verificación de edad. Exige la confirmación de que el usuario es mayor de edad antes de la primera conversación y deja esto en los términos de tu servicio.
- Prohibición de menores. El contenido sexual que involucre a menores está prohibido, sin excepciones. Bloquea en tu capa cualquier persona o solicitud en ese sentido.
- Límite por usuario. Define un tope diario de mensajes para evitar el abuso y el gasto inesperado.
- Privacidad. Guarda lo mínimo necesario y avisa qué se almacena. En esta API, los prompts no se usan para entrenamiento.
- Solo texto. La API no genera imagen, audio ni video.
Próximos pasos
Con la base lista, las mejoras más útiles son: guardar conversaciones en base de datos, mostrar el saldo para ti por el encabezado X-Balance-USD, usar tools para que el bot consulte tus datos y el modo JSON cuando necesites una salida estructurada. La documentación cubre cada recurso. Para entender qué cambia al quitar filtros a un modelo y cómo se relaciona con tu producto, lee IA sin filtro.
Las recargas van de US$ 20 a US$ 500, en USDT en la red TRC20 o USDC en la red Base.
