架构是怎样的
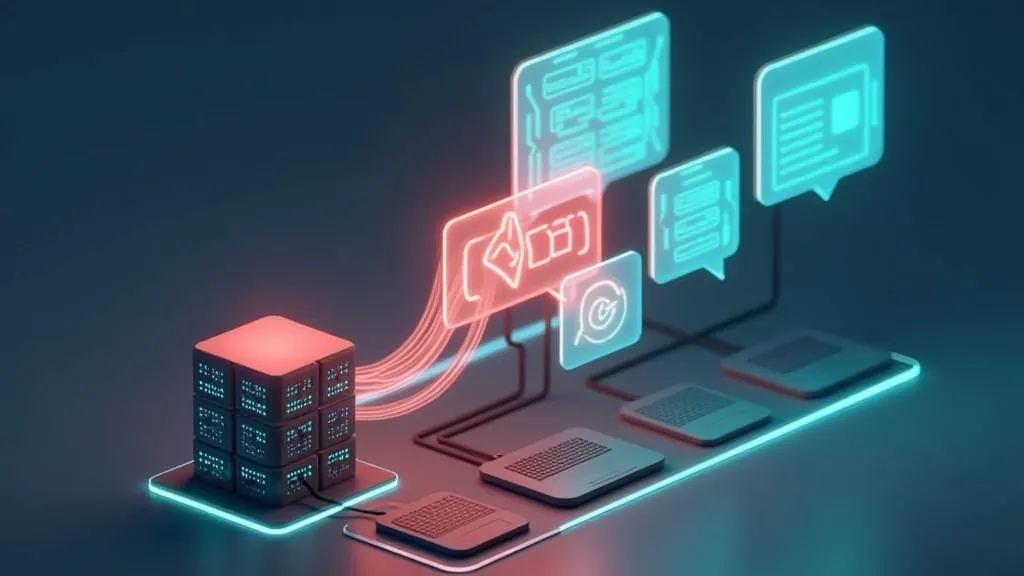
一个自建的无审查聊天机器人由三部分组成:用户界面、你的服务器和语言 API。服务器是核心。它保存 API 密钥,维护每次对话的历史记录,并决定向模型发送什么。界面从不直接与 API 通信,因为这会暴露密钥。
此 API 兼容 OpenAI:只需将 Base URL 更改为 https://api.llmsemcensura.com/v1 并使用模型 uncensored,官方 SDK 即可工作。如果你还没有密钥,在此创建;注册即赠送 US$ 0.50 测试额度,点击即可获取。
在搭建服务器之前,先用 Python 进行最小化测试以验证连接,确保密钥和 URL 正确:
from openai import OpenAI
client = OpenAI(base_url="https://api.llmsemcensura.com/v1", api_key="SUA_CHAVE")
r = client.chat.completions.create(
model="uncensored",
messages=[{"role": "user", "content": "Olá, tudo bem?"}],
)
print(r.choices[0].message.content)带有流式输出的 Node 服务器
该示例使用 Express 接收消息并通过 SSE(服务器发送事件)返回响应,使文本逐步显示在屏幕上。使用 npm install express openai 安装依赖项,并将密钥放入 API_KEY。
import express from "express";
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://api.llmsemcensura.com/v1",
apiKey: process.env.API_KEY,
});
const SISTEMA =
"Você é a Lia, uma assistente de conversa direta e bem-humorada. " +
"Responda em português do Brasil. Os usuários são adultos.";
const sessoes = new Map(); // id da sessão -> histórico
const app = express();
app.use(express.json());
app.post("/chat", async (req, res) => {
const { id, mensagem } = req.body;
const historico = sessoes.get(id) ?? [];
historico.push({ role: "user", content: mensagem });
res.setHeader("Content-Type", "text/event-stream");
res.setHeader("Cache-Control", "no-cache");
try {
const stream = await client.chat.completions.create({
model: "uncensored",
messages: [{ role: "system", content: SISTEMA }, ...historico.slice(-12)],
stream: true,
max_tokens: 500,
});
let texto = "";
for await (const chunk of stream) {
const parte = chunk.choices[0]?.delta?.content ?? "";
if (parte) {
texto += parte;
res.write("data: " + JSON.stringify(parte) + "\n\n");
}
}
historico.push({ role: "assistant", content: texto });
sessoes.set(id, historico);
res.write("data: [FIM]\n\n");
} catch (e) {
res.write("data: " + JSON.stringify("erro: tente de novo em instantes") + "\n\n");
}
res.end();
});
app.listen(3000);请求体包含一个 id 会话标识和 mensagem。一个常见的错误是在调用时忘记添加 Content-Type: application/json 请求头,这会导致服务器端请求体为空。通过浏览器或请求工具测试时,你应该看到内容逐段到达,最后出现 [FIM] 标记。
历史记录:保存什么,发送什么
API 没有对话记忆。每次调用都包含模型需要查看的消息。在上面的代码中,完整历史记录存储在 Map 中,只有最后 12 条消息会发送给 API(historico.slice(-12))。
为什么要截断
如果不截断,输入会随着每一轮对话增长,成本也随之增加。虽然 100,000 token 的上下文窗口可以容纳很长的对话,但那样会很昂贵且缓慢,且收益不成比例。
系统提示词
它定义了机器人的身份和说话方式。简短具体的提示词比长长的禁止和要求的列表效果更好。说明语言、语气、平均回复长度和目标受众。系统提示词中的每个 token 都会在每次调用中重新发送,因此 250 个 token 的成本远低于 2,000 个。每次只测试一项更改,并保存有效的版本。
长期记忆
如果对话需要记住旧事实,请偶尔让模型生成一段简短摘要,并将其放在系统提示词之后。在生产环境中,将 Map 替换为数据库,因为服务器重启时它会清零,且无法在多个实例间共享状态。
每条消息的成本
价格为输入 1M 个 token US$ 0.15,输出 1M 个 token US$ 0.50。示例假设:250 个 token 的系统提示词,80 个 token 的用户消息,300 个 token 的回复,以及 12 条历史记录消息(每方 6 条)。
- 历史记录:6 x 80 + 6 x 300 = 2,280 个 token
- 输入:250 + 2,280 + 80 = 2,610 个 token,即 US$ 0.0003915
- 输出:300 个 token,即 US$ 0.00015
- 总计:每条消息 US$ 0.0005415
1,000 条消息成本约为 US$ 0.54。US$ 0.50 的测试额度可支持约 923 条消息,US$ 20 的充值可支持约 36,900 条。要查看充值档位和奖励,请打开价格。失败或被拒的请求不收费。
限制、429 错误和队列
完整密钥允许同时 8 个请求,每分钟 300 个;测试密钥允许同时 2 个,每分钟 60 个。当热门聊天超过此限制时,API 会返回 HTTP 429 错误,代码为 rate_limited 或 concurrency。在临时过载时,429 错误会附带 Retry-After: 5。请注意,流式响应会占用位置直到流结束,因此长回复会占用并发资源更长时间。
一个简单的重试函数会尊重这个间隔:
async function comRetry(fn, tentativas = 3) {
for (let i = 0; i < tentativas; i++) {
try {
return await fn();
} catch (e) {
if (e.status === 429 && i < tentativas - 1) {
await new Promise((r) => setTimeout(r, 5000)); // Retry-After: 5
continue;
}
throw e;
}
}
}对于大量同时在线的用户,请在服务器中设置队列,并限制同时生成的对话数量。
成人使用规则
该模型由独立提供商托管,对合法的成人内容不作拒答。发布此类聊天机器人的开发者需承担使用责任。以下是一些基本准则:
- 年龄验证。 在首次对话前要求用户确认已成年,并将此要求写入服务条款。
- 禁止未成年人。 禁止涉及未成年人的性内容,无例外。请在您的应用层屏蔽任何与此相关的人设或请求。
- 用户限额。 设置每日消息上限,以防止滥用和意外消耗。
- 隐私。 仅保留必要数据并告知存储内容。在此 API 中,提示词不用于训练。
- 仅文本。 API 不生成图像、音频或视频。
后续步骤
基础搭建完成后,最实用的改进包括:将对话保存到数据库、通过 X-Balance-USD 标头向你展示余额、使用 tools 让机器人查询你的数据,以及在需要结构化输出时使用 JSON 模式。文档 涵盖了各项功能。要了解移除模型过滤器带来的变化及其与你的产品的关联,请阅读 无审查 AI。
充值金额从 US$ 20 到 US$ 500不等,支持通过 TRC20 网络的 USDT 或 Base 网络的 USDC 支付。
